
אוטומציה לתמיכה עם RAG: מיון פניות והכנת תשובה ראשונה

בכל פעם שפנייה מגיעה לתיבת התמיכה שלכם, הצוות שלכם כנראה שואל את אותן שלוש שאלות, מחטט בתיעוד מיושן ומשיב בגרסה מעט שונה לתשובה של השבוע שעבר. אין לכם בעיה של עומס פניות; יש לכם בעיה של שליפת נתונים וניתוב, שמתחפשת לצוואר בקבוק תפעולי. על ידי הטמעה של Retrieval-Augmented Generation (RAG) , תוכלו לשלוף ידע רלוונטי ולנתב פניות לבדיקה. מדדו את זמן התגובה הראשוני מול נקודת הייחוס שלכם; התוצאה תלויה באיכות הידע, בניתוב ובכיסוי התמיכה. ארכיטקטורת המערכת מבוססת על ארבעה כלים מחוברים הפועלים כלולאת אוטומציה מאוחדת:
- מנוע קליטה: Zendesk או Gmail קולטים את הפניות הנכנסות.
- עמוד השדרה של זרימת העבודה: n8n מנרמל את הנתונים ומטפל בלוגיקת הניתוב.
- זיכרון וקטורי: Supabase מאחסן ידע פנימי היסטורי ו"אובייקטי אמת".
- מנוע ניסוח: ChatGPT מייצר טיוטות תגובה הקשריות ומדויקות להפליא.
כיצד RAG יכול לקצר את זמני התגובה בתמיכת לקוחות?
הטמעת צינור (pipeline) של Retrieval-Augmented Generation (RAG) מקצרת את זמני התגובה הראשוניים בתמיכת לקוחות באמצעות פלטפורמת אוטומציה כמו n8n, השולפת באופן מיידי תיעוד טכני רלוונטי ממסד נתונים וקטורי (כמו Supabase) ברגע הגעת הפנייה, ומייצרת טיוטת תגובה מדויקת לבדיקת הנציג.
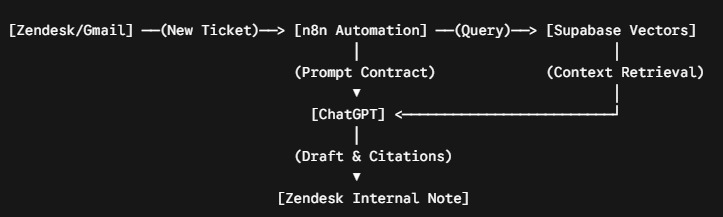
כדי למנוע הזיות של הבינה המלאכותית ולשמור על בקרת איכות קפדנית, n8n מפעיל את מודל השפה (LLM) באמצעות חוזה הנחיה (prompt contract)נוקשה: עליו לנסח תשובות אך ורק מתוך המקורות שנשלפו מ-Supabase. אם התיעוד הטכני סותר או חסר, המודל מונחה לייצר שאלת הבהרה ממוקדת במקום לנחש. הטיוטה הסופית שנוצרה על ידי ה-AI, יחד עם ציטוט המקורות הספציפיים שלה, נדחפת חזרה ל-Zendesk כהערה פנימית. כך נשמר הגורם האנושי בתהליך לאישור סופי, ובמקביל נשמרת התשובה המאומתת כ"אובייקט אמת" לשימוש חוזר בפניות עתידיות.
מדריך שלב אחר שלב: בניית תהליך עבודה אוטומטי למיון כרטיסי תמיכה עם n8n
ניהול תור תמיכה בעל נפח גבוה בזמן תקלה במערכת חושף במהירות חוסר יעילות בתעדוף. כאשר מגיע מבול של פניות בנוסח "ה-API מושבת", מהנדסים מבזבזים לעיתים קרובות שעות בניסיון לקבוע אם שורש הבעיה הוא מגבלת קצב (rate-limiting), הגדרת אימות שגויה או תקלה גלובלית. כדי להפוך את שכבת המיון הזו לאוטומטית, הגדירו טריגר Webhook ב-n8n שיופעל עם כל כרטיס חדש ב-Zendesk. זרימת העבודה מחלצת באופן מיידי מטא-דאטה מרכזי, כולל גוף הפנייה, דומיין השולח, שדות סביבה מותאמים אישית ו-20 ההערות הפנימיות האחרונות, ומנסחת מחדש את הבעיה של המשתמש לשאילתה אחת ונקייה המותאמת במיוחד לשליפה ממסד נתונים וקטורי.
{
  "ticket_id": "48213",
  "sender_domain": "customer-example.com",
  "environment": "production",
  "product_area": "billing",
  "internal_notes_used": 20,
  "retrieval_query": "Invoice PDF fails to generate after plan upgrade in production; 500 error on /billing/invoices"
}
רוצים ליישם את זה בעסק שלכם?
אמצעי הגנה מרכזיים לשליפת נתונים שיש ליישם:
- הפרדה בין סיווג למתן מענה: אל תאפשרו ל-LLM שלכם לסווג את הפנייה ולנסח את התגובה באותה קריאת API, שכן הדבר מעלה משמעותית את שיעורי ההזיות (hallucinations).
- התאמת הקשר רב-שכבתית: בצעו שאילתות ב-Supabase באמצעות חיפוש וקטורי סמנטי בשילוב עם סינון מטא-דאטה קפדני – כגון דגלי תקריות פעילות, דרגי לקוחות ומספרי גרסאות תוכנה.
- בדיקה אנושית (Human-in-the-Loop): פרסמו את כל טיוטות ה-AI בחזרה ל-CRM כהערות פנימיות בלבד ולא כתגובות גלויות, כדי להגן על קבצי ההגדרות של הלקוח מפני צעדים לא מאומתים.
לאחר השליפה, המערכת מצמידה את שאילתת המשתמש לנתונים היסטוריים מאותו דומיין ב-30 הימים האחרונים. כדי למנוע רעשי חיפוש לא רלוונטיים, אכפו סף ציון דמיון וקטורי קפדני וסננו תוצאות לפי גרסת המוצר הנוכחית של המשתמש. כאשר נמצאת התאמה, n8n מעצבת את הטיוטה בתוך Zendesk ומצרפת ציטוטים מפורשים למסמכי מעקב פנימיים. הנציגים בודקים, מבצעים התאמות ושולחים את התגובה בלחיצה אחת, מה שמאפשר לצוות הטכני הבכיר שלכם להשתחרר לחלוטין מצוואר הבקבוק של המיון הראשוני.
בניית מאגר ידע AI רב-פעמי: הפיכת כרטיסי תמיכה הנדסיים לנתונים וקטוריים
המכשול העיקרי בהרחבת מערכת תמיכה מבוססת RAG אינו הטכנולוגיה, אלא הקושי בתיעוד הידע הארגוני הסמוי של מהנדסים בכירים. הציפייה מצוותים טכניים עמוסים לעצור את עבודתם כדי לכתוב תיעוד מקיף באופן ידני כמעט לעולם לא עובדת, כיוון שהנטל האדמיניסטרטיבי הוא מיידי בעוד שהתועלת נתפסת כמופשטת. הפתרון הוא לתכנן את תהליך האוטומציה כך שילכוד ידע פנימי כתוצר לוואי טבעי של פתרון כרטיסי תמיכה יומיומיים. על ידי הטמעת איסוף נתונים מובנה ישירות בכלים שהצוות שלכם כבר משתמש בהם, אתם הופכים פיסות מידע מפוזרות מ-Slack, הערות ב-GitHub ותכתובות פנימיות לנתונים נקיים ומובנים.
מסגרת עבודה ל-10 שניות לשמירה על תקינות נתונים
כדי לבנות בסיס ידע שמזין את עצמו, הגדירו את n8n כך שיבקש מהצוות שלכם שלושה קלטי נתונים מהירים רגע לפני שכרטיס מסומן כפתור:
| שלב | הפעולה הנדרשת ב-Zendesk או ב-HubSpot | העיבוד ב-n8n וב-Supabase | מטרת השלב |
| 1 | בחירת תגית הרכיב העיקרי | בודק איזה חלק במוצר הושפע. | מעביר לצוות הפיתוח. |
| 2 | הזנת קוד השגיאה או המזהה | יוצר מידע מובנה שאפשר לחפש לפיו. | מצמצם צורך בניתוב ידני. |
| 3 | הגדרת מצב הפתרון: מאושר או פתרון זמני | מעביר מידע שאומת לאחסון וקטורי לשימוש חוזר. | עוזר לשמור על מידע עקבי. |
אם מהנדס מדלג על פרמטרים אלו, התשובה עדיין תישלח ללקוח, אך המערכת תמנע מהנתונים לעבור לספריית הווקטורים הראשית. גישה זו מונעת פיקוח נוקשה ומגבילה במקום זאת את מה שנכנס לזיכרון לטווח ארוך של ה-AI. העבירו את מדדי הצוות מ"כיסוי תיעוד" מעורפל והתמקדו ב-KPIs ברורים שמניעים הכנסות, כמוצמצום מענה לשאלות חוזרותו-זמן ממוצע לפתרון (MTTR). כאשר מהנדסים רואים שהקדשת עשר שניות לתיוג בעיה מונעת לחלוטין עשרות הפרעות זהות ב-Slack בהמשך, האימוץ של המערכת קורה באופן טבעי.
רוצים שמישהו יבנה את זה עבורכם?
Webflowforge מציעה הטמעת תהליכי עבודה מבוססי בינה מלאכותית— מערכות תמיכה מבוססות RAG, מיון פניות ואוטומציה של ידע — עבור חברות שירות וצוותי SaaS.ספרו לנו על הפרויקט שלכם ואנחנו נגדיר את היקפו יחד איתכם.
פלייבוק קשור:התיעוד שלכם לא עובד כי אף אחד לא אחראי על האמת
שאלות נפוצות
על ידי הגדרת חוזה פרומפט קפדני דרך n8n. יש להנחות את ה-LLM במפורש לנסח תשובות רק על בסיס הקשר שנשלף ממסד הנתונים הווקטורי המאומת שלכם. אם חסר תיעוד, המודל מחזיר שאלת הבהרה במקום לייצר קוד או תשובות שלא אומתו.
מסד נתונים Postgres עם ההרחבה pgvector (כמו Supabase) בשילוב embeddings סמנטיים. תצורה זו מאפשרת לשלב חיפוש טקסט סמנטי עם מסנני מטא-דאטה מובנים, כמו גרסאות מוצר או רמות חשבון.
כדאי להתחיל בטיוטות שנציג בודק לפני השליחה. מומלץ לאפשר תשובות אוטומטיות רק בקטגוריות מצומצמות ונבדקות היטב, שבהן השליפה מוצאת מקור מאושר ברמת ביטחון גבוהה, ולהעביר כל דבר אחר לטיפול אנושי.